从哪条路接 Fish Audio 中文版 API
三条路按你的习惯选,每一条十分钟内都能跑出第一段音频。
Fish Audio 中文版 API 怎么开通、密钥在哪
API 向旗舰会员开放,密钥就是请求头里的 sign。网页端能用的功能,API 都能调;API 本身不加收费用,用的是套餐里的字符额度。这份文档不用登录就能完整阅读。
网页端注册赠送的 150,000 字符和不限次数的声音克隆只在网页端使用,不包含 API 调用。密钥如果泄露,添加企业微信联系我们重置。
三步跑通 Fish Audio 中文版 API
顺序是固定的:先拿到音色 ID,再提交合成任务,最后轮询取结果。
- 拿音色 ID:调
GET /api/third/reference/list,从list[].audioId里取一个;没有现成音色就先用/reference/upload上传一段 3–60 秒的干声。 - 提交合成任务:调
POST /api/third/tts/create,audioId填上一步的值,返回taskId。 - 轮询取结果:每 2 秒调一次
GET /api/third/tts/result?taskId=,status变成 2 时取voiceUrl。等待期间别重复提交任务。
# 1) 拉音色列表,取 audioId
curl "https://openapi.aivoiceapi.cn/api/third/reference/list?page=1&pageSize=10" \
  -H "sign: $VOICE_API_KEY"

# 2) 提交合成任务,拿 taskId
curl -X POST https://openapi.aivoiceapi.cn/api/third/tts/create \
  -H "sign: $VOICE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
        "content": "欢迎来到 Fish Audio 中文版",
        "audioId": "<audioId>",
        "style": "2",
        "speed": 1.0,
        "targetSpeech": "mandarin"
      }'

# 3) 轮询,status=2 时读 voiceUrl
curl "https://openapi.aivoiceapi.cn/api/third/tts/result?taskId=<taskId>" \
  -H "sign: $VOICE_API_KEY"
import os, time, requests
BASE = "https://openapi.aivoiceapi.cn"
H = {"sign": os.environ["VOICE_API_KEY"]}
# 1) 拉音色
r = requests.get(f"{BASE}/api/third/reference/list",
headers=H, params={"page": 1, "pageSize": 10}).json()
assert r["code"] == 0, r["msg"] # 先看 code,再看数据
audio_id = r["data"]["list"][0]["audioId"]
# 2) 提交任务
r = requests.post(f"{BASE}/api/third/tts/create", headers=H, json={
"content": "欢迎来到 Fish Audio 中文版",
"audioId": audio_id,
"style": "2",
"speed": 1.0,
"targetSpeech": "mandarin",
}).json()
assert r["code"] == 0, r["msg"]
task_id = r["data"]["taskId"]
# 3) 每 2 秒查一次,不要重复提交
while True:
time.sleep(2)
r = requests.get(f"{BASE}/api/third/tts/result",
headers=H, params={"taskId": task_id}).json()
assert r["code"] == 0, r["msg"]
data = r["data"]
if data["status"] == 2:
print(data["voiceUrl"]); break
if data["status"] == 3:
raise RuntimeError("合成失败")const BASE = "https://openapi.aivoiceapi.cn";
const KEY = process.env.VOICE_API_KEY;
const H = { sign: KEY, "Content-Type": "application/json" };
const sleep = ms => new Promise(r => setTimeout(r, ms));
// 1) 拉音色
const listRes = await fetch(
`${BASE}/api/third/reference/list?page=1&pageSize=10`,
{ headers: { sign: KEY } }
).then(r => r.json());
if (listRes.code !== 0) throw new Error(listRes.msg); // 先看 code
const audioId = listRes.data.list[0].audioId;
// 2) 提交任务
const createRes = await fetch(`${BASE}/api/third/tts/create`, {
method: "POST",
headers: H,
body: JSON.stringify({
content: "欢迎来到 Fish Audio 中文版",
audioId,
style: "2",
speed: 1.0,
targetSpeech: "mandarin",
}),
}).then(r => r.json());
if (createRes.code !== 0) throw new Error(createRes.msg);
const taskId = createRes.data.taskId;
// 3) 每 2 秒查一次,不要重复提交
while (true) {
await sleep(2000);
const res = await fetch(
`${BASE}/api/third/tts/result?taskId=${taskId}`,
{ headers: { sign: KEY } }
).then(r => r.json());
if (res.code !== 0) throw new Error(res.msg);
if (res.data.status === 2) { console.log(res.data.voiceUrl); break; }
if (res.data.status === 3) throw new Error("合成失败");
}跑通的标志是第 2 步拿到 data.taskId,第 3 步在 status=2 时拿到 data.voiceUrl。
Fish Audio 中文版 API 怎么鉴权、返回什么
Base URL 与鉴权
https://openapi.aivoiceapi.cn每个请求带请求头 sign: <你的密钥>。也可以放在 query 里(?sign=),但优先用请求头。密钥错误或旗舰会员到期时,会返回「sign无效」或「会员已过期」。
统一响应
{
  "code": 0,
  "msg": "操作成功",
  "data": { }
}code=0表示成功,7是通用失败,1001是字数超限。- 失败时 HTTP 状态码仍可能是 200,所以一律先判断
code。 - 失败时
msg是中文原因,可以直接展示给用户。
Fish Audio 中文版 API 接口清单
一共 12 个接口,分四组:声音模型 3 个、语音合成 4 个、降噪 2 个、声音设计 3 个。路径都以 /api/third 开头,除 openapi.json 外都要带 sign 头。机读规范地址:https://openapi.aivoiceapi.cn/api/third/openapi.json,可以直接导入扣子、Dify、n8n。
声音模型3 个接口
POST/api/third/reference/upload创建声音模型
传一段音频建立音色,拿到的 audioId 可以马上用来合成。
| 表单(multipart/form-data) | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| file | binary | 是 | — | mp3 / wav / m4a,≤50MB,2–60 秒,建议 3–10 秒干声 |
| name | string | 是 | — | 音色名称 |
| describe | string | 否 | — | 音色描述 |
curl -X POST https://openapi.aivoiceapi.cn/api/third/reference/upload \
  -H "sign: $VOICE_API_KEY" \
  -F "file=@/path/voice.wav" \
  -F "name=主播A" \
  -F "describe=温和女声"
{
"code": 0, "msg": "操作成功",
"data": { "audioId": "role_xxx", "name": "主播A", "describe": "温和女声" }
}GET/api/third/reference/list获取声音模型列表
列出账号里所有可用音色,网页端建的和接口上传的都在里面。page 默认 1,pageSize 默认 10、最大 30。
| Query 参数 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| page | int | 否 | 1 | 页码 |
| pageSize | int | 否 | 10 | 每页条数,最大 30 |
GET /api/third/reference/list?page=1&pageSize=10
sign: YOUR_API_KEY
{
"code": 0, "msg": "操作成功",
"data": {
"list": [
{ "audioId": "role_xxx", "name": "主播A", "describe": "温和女声" }
],
"total": 8, "page": 1, "pageSize": 10
}
}DELETE/api/third/reference/delete删除声音模型
按 audioId 删除音色,删除后不能再用于合成。
| Query 参数 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| audioId | string | 是 | — | 模型 ID |
curl -X DELETE "https://openapi.aivoiceapi.cn/api/third/reference/delete?audioId=role_xxx" \
  -H "sign: $VOICE_API_KEY"
{ "code": 0, "msg": "操作成功", "data": {} }语音合成4 个接口
POST/api/third/file/uploadCustom上传情绪参考音频
上传一段情绪参考音频,拿到的文件名用在合成接口的 emotionPath 上(genre=2 时)。这是临时文件,会被定时清理,过期要重新上传。
| 表单(multipart/form-data) | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| file | binary | 是 | — | mp3 / wav / m4a,≤50MB,时长 2–60 秒 |
curl -X POST https://openapi.aivoiceapi.cn/api/third/file/uploadCustom \
  -H "sign: $VOICE_API_KEY" \
  -F "file=@/path/emotion.wav"
{
"code": 0, "msg": "操作成功",
"data": { "emotionPath": "20260817_xxxxxx.wav" }
}POST/api/third/tts/create提交合成任务(异步)
提交后立刻返回 taskId,结果用 /tts/result 查。最多 30 个任务同时排队;生成的音频和记录只保留 1 天,记得及时下载。content 里可以插停顿标记:#0.3# #0.5# #1.0# #1.5# #2.0# #3.0#。
| 请求体(JSON) | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| content | string | 是 | — | 要合成的文本,上限 10000 字符,超出返回 code=1001 |
| audioId | string | 是 | — | 音色 ID,来自 /reference/list 或 /reference/upload |
| style | string | 是 | — | 必须是字符串。"1"=V2.0,"2"=V2.5(只有它支持情绪),"3"=方言 / 多语言。所选 style 不支持传入的 targetSpeech 时,服务端会改写为 "3" |
| speed | number | 否 | 1.0 | 0.5–2.0,一位小数;方言 / 多语言链路上限 1.5,服务端会自动压缩 |
| targetSpeech | enum | 否 | 自动判定 | 目标语言或方言,57 个取值,建议总是显式传;枚举外的语言改用 style="3" 且不传本字段 |
| genre | int | 否 | 0 | 情绪控制方式,只在 style="2" 时生效:0=跟随参考音频,1=情绪向量(配 ext),2=情绪参考音频(配 emotionPath) |
| ext | object | genre=1 | — | 8 维情绪向量 happy / angry / sad / afraid / disgusted / melancholic / surprised / calm,每维 0–1,可同时给多个;传未知字段会报错 |
| emotionPath | string | genre=2 | — | 来自 /file/uploadCustom 的文件名 |
{
  "content": "欢迎来到 Fish Audio 中文版。",
  "audioId": "role_xxx",
  "style":   "2",
  "speed":   1.0,
  "targetSpeech": "mandarin"
}
{
"code": 0,
"msg": "操作成功",
"data": { "taskId": "task_xxx", "status": 1 }
}GET/api/third/tts/list查询合成历史
分页列出历史合成任务,pageSize 最大 30。
| Query 参数 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| page | int | 否 | 1 | 页码 |
| pageSize | int | 否 | 10 | 每页条数,最大 30 |
GET /api/third/tts/list?page=1&pageSize=10
sign: YOUR_API_KEY
{
"code": 0, "msg": "操作成功",
"data": {
"list": [
{ "taskId": "task_xxx", "status": 2, "voiceUrl": "https://.../xxx.mp3" }
],
"total": 42, "page": 1, "pageSize": 10
}
}GET/api/third/tts/result按 taskId 查结果
用提交时拿到的 taskId 查,建议 2 秒一次;下载音频时同样要带 sign(请求头或 URL 参数都行)。
| Query 参数 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| taskId | string | 是 | — | 任务 ID |
GET /api/third/tts/result?taskId=task_xxx
sign: YOUR_API_KEY
{
"code": 0,
"msg": "操作成功",
"data": {
"taskId": "task_xxx",
"status": 2, // 1=处理中 2=已完成 3=失败
"voiceUrl": "https://.../xxx.mp3" // status=2 时才有
}
}语音降噪2 个接口
POST/api/third/denoise/upload提交降噪
上传一段 3–60 秒的音频去噪,返回 taskId。每个账号同时最多 5 个降噪任务进行中,降噪不单独计费。
| 表单(multipart/form-data) | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| file | binary | 是 | — | 音频文件,3–60 秒 |
curl -X POST https://openapi.aivoiceapi.cn/api/third/denoise/upload \
  -H "sign: $VOICE_API_KEY" \
  -F "file=@/path/noisy.wav"
{
"code": 0, "msg": "操作成功",
"data": { "taskId": "dn_xxx" }
}GET/api/third/denoise/poll查询降噪结果
这里的 status 是字符串(processing / completed / failed),和合成接口的数字状态不一样;完成后取 filePath,失败时看 message。
| Query 参数 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| taskId | string | 是 | — | 降噪任务 ID |
GET /api/third/denoise/poll?taskId=dn_xxx
sign: YOUR_API_KEY
{
"code": 0, "msg": "操作成功",
"data": {
"status": "completed", // processing | completed | failed
"filePath": "https://.../clean.wav",
"message": "" // status=failed 时是失败原因
}
}声音设计3 个接口
POST/api/third/dubbing/create提交声音设计(异步)
不需要参考音频,用一句文字描述或一组方言参数直接生成音色并合成,返回 dubbId。同时最多 5 个任务进行中,结果保留 1 天。
| 请求体(JSON) | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| content | string | 是 | — | 要合成的文本,上限 1000 字节,一个汉字 3 字节 |
| engine | int | 否 | 1 | 设计方式:1=描述设计,2=方言设计 |
| description | string | engine=1 | — | 用一句话描述音色,例如「温和的女声,语速适中,像电台主播」。engine=2 时如果填了,会整体按描述生成,其他参数忽略 |
| language | enum | 否 | — | 语言 / 方言,见下方取值表。仅 engine=2 生效 |
| gender | enum | 否 | — | male / female。仅 engine=2 生效 |
| age | enum | 否 | — | child / teen / youth / middle_aged / elderly。仅 engine=2 生效 |
| pitch | enum | 否 | — | very_low / low / medium / high / very_high。仅 engine=2 生效 |
| voiceStyle | enum | 否 | 自然 | 留空=自然,whisper=耳语。仅 engine=2 生效 |
| accent | enum | 否 | — | 英文口音,只在 language="english" 时可用,取值见参数规则「声音设计」小节 |
{
  "content": "欢迎来到 Fish Audio 中文版",
  "engine":  1,
  "description": "温和的女声,语速适中,像电台主播"
}
{
"content": "今天天气不错,出去走走吧",
"engine": 2,
"language": "sichuan",
"gender": "female",
"age": "youth",
"pitch": "medium",
"voiceStyle": "",
"accent": ""
}{
"code": 0, "msg": "操作成功",
"data": { "dubbId": "dubb_xxx" }
}GET/api/third/dubbing/result查询声音设计结果
用 dubbId 查,完成后取 voiceUrl。
| Query 参数 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| dubbId | string | 是 | — | 声音设计任务 ID |
GET /api/third/dubbing/result?dubbId=dubb_xxx
sign: YOUR_API_KEY
{
"code": 0, "msg": "操作成功",
"data": {
"dubbId": "dubb_xxx",
"status": 2, // 1=处理中 2=已完成 3=失败
"voiceUrl": "https://.../xxx.mp3" // status=2 时才有
}
}GET/api/third/dubbing/list声音设计任务列表
分页列出任务;接口不返回当时的设计参数和文案,需要展示的话请自己保存。
| Query 参数 | 类型 | 必填 | 默认 | 说明 |
|---|---|---|---|---|
| page | int | 否 | 1 | 页码 |
| pageSize | int | 否 | 10 | 每页条数,最大 30 |
GET /api/third/dubbing/list?page=1&pageSize=10
sign: YOUR_API_KEY
{
"code": 0, "msg": "操作成功",
"data": {
"list": [
{ "dubbId": "dubb_xxx", "status": 2, "voiceUrl": "https://.../xxx.mp3" }
],
"total": 3, "page": 1, "pageSize": 10
}
}Fish Audio 中文版 API 参数怎么填
分「语音合成」和「声音设计」两块。接口卡片里的「参数详解」链接会跳到这里对应的小节。
语音合成(/tts/create)
style 必须传字符串
"style": "2" 正确,"style": 2 会返回类型错误。
"1"V2.0 基础合成:不支持情绪,genre只能是 0。"2"V2.5:唯一支持情绪控制的档位。"3"方言 / 多语言:不支持;传了genre/ext不会报错,但不生效。
传入的 targetSpeech 不被所选 style 支持时,服务端会把 style 改成 "3",响应里会返回改写后的值。
情绪控制有三种方式(只在 style="2" 时)
genre=0:跟着参考音频的情绪走,默认值,不用传别的。genre=1:用ext传 8 维情绪向量(happy / angry / sad / afraid / disgusted / melancholic / surprised / calm),每维 0–1,可以多维一起给;出现未知字段会直接报错。genre=2:先调/file/uploadCustom拿到文件名,再填进emotionPath。
网页端的情绪控制是专业会员权益;用旗舰会员的 API Key 调接口时默认可用,不用另外开通。
targetSpeech(目标语言 / 方言)
可以不传,但强烈建议显式传。不传时服务端按文本自动判断,短句或中英混排容易判错。
mandarin、english:style 1 / 2 / 3 都能用,支持情绪。ja、es、ar:style="2" 时支持情绪;传 style="1" 会被改成 "3"。- 其余 14 种中文方言、5 种民族语言和 33 种外语:style 传 "3",不支持情绪。
- 枚举里没有的语言会直接报「暂不支持该语言」,任务不会创建。这时改用 style="3" 并且不传 targetSpeech,交给多语言模型按文本处理。
枚举收录 57 个,服务端实际支持 100 多个语种,枚举里没有不代表不能用,可以试传。
speed 与轮询
speed入参上限 2.0;方言 / 多语言链路的模型上限是 1.5,服务端下发前会自动压缩,入参不用改。- 提交后建议每 2 秒查一次
/tts/result,直到 status 变成 2 或 3。 - status=1 时继续等,不要重复提交任务;最多 30 个任务同时排队。
targetSpeech 全部取值(57 个)
支持情绪控制5
style="2" 时可以配 genre / ext;mandarin、english 三个 style 都能用
mandarin普通话english英语ja日语es西班牙语ar阿拉伯语
中文方言14
这一组固定走 style="3",不支持情绪控制
sichuan四川话northeast东北话henan河南话shaanxi陕西话guizhou贵州话yunnan云南话guilin桂林话jinan济南话shijiazhuang石家庄话gansu甘肃话ningxia宁夏话qingdao青岛话yue粤语nan闽南语
民族语言5
固定走 style="3",不支持情绪控制
ug维吾尔语bo藏语mn蒙古语kk哈萨克语ky柯尔克孜语
其他语言33
固定走 style="3",不支持情绪控制
ko韩语fr法语de德语ru俄语pt葡萄牙语it意大利语th泰语vi越南语id印尼语ms马来语hi印地语fa波斯语tr土耳其语ur乌尔都语bn孟加拉语ta泰米尔语nl荷兰语pl波兰语sv瑞典语no挪威语da丹麦语fi芬兰语el希腊语cs捷克语hu匈牙利语uk乌克兰语he希伯来语fil菲律宾语my缅甸语km高棉语lo老挝语ne尼泊尔语sw斯瓦希里语
声音设计(/dubbing/create)
engine=1 描述设计
只需要 content 和 description,用一句话描述音色,例如「温和的女声,语速适中,像电台主播」。
engine=2 方言设计
用下表的英文取值组合出音色,支持 12 种中文方言和 10 种英文口音。如果同时传了 description,会整体按描述生成,下表参数全部忽略。
文案怎么写:中文方言用普通话文案即可;粤语、维吾尔语、英文要用对应语言写;闽南语只支持台罗拼音(Tâi-lô),不支持汉字。
| 参数 | 可选值 |
|---|---|
| language(中文方言) | sichuan 四川 / northeast 东北 / henan 河南 / shaanxi 陕西 / guizhou 贵州 / yunnan 云南 / guilin 桂林 / jinan 济南 / shijiazhuang 石家庄 / gansu 甘肃 / ningxia 宁夏 / qingdao 青岛 |
| language(其他) | chinese 普通话 / cantonese 粤语 / minnan 闽南语 / uyghur 维吾尔语 / english 英文;表外语言直接传英文语言名(如 Thai) |
| accent(英文口音) | american / british / australian / canadian / indian / chinese / korean / japanese / portuguese / russian;只在 language="english" 时可用 |
| gender | male 男声 / female 女声 |
| age | child 儿童 / teen 少年 / youth 青年 / middle_aged 中年 / elderly 老年 |
| pitch | very_low 极低 / low 低 / medium 中 / high 高 / very_high 极高 |
| voiceStyle | 留空 = 自然(默认)/ whisper 耳语 |
Fish Audio 中文版网页功能在 API 里怎么对应
| API 参数 | 网页端对应 | 说明 |
|---|---|---|
style="1" | V2.0 极速引擎 | 中英文,长文本稳定 |
style="2" | V2.5 高保真引擎 | 唯一支持情绪;中英日西阿 |
style="3" | 方言与多语言 | 不支持情绪 |
genre 0 / 1 / 2 | 情绪三种控制方式 | 只在 style="2" 时 |
speed | 语速滑杆 0.5–2.0x | 方言链路上限 1.5 |
targetSpeech | 「选择配音语言」弹窗 | 网页端开放 14 种方言 + 7 种民族语言 + 35 种外语;API 枚举 57 个,实际支持 100+ |
/reference/upload | 创建声音模型 | API 允许 3–60 秒,建议 3–10 秒干声 |
/denoise/* | AI 降噪 | 网页端免费不计额度;API 也不单独计费 |
/dubbing/create engine=1 | 声音设计 · 描述设计 | 用 description 描述音色 |
/dubbing/create engine=2 | 声音设计 · 方言设计 | 12 种中文方言 + 10 种英文口音 |
Fish Audio 中文版 API 接入扣子、Dify、Claude Code
六个平台底下调的是同一组 /api/third/* 接口,扣的也是同一份额度。点你在用的平台,每个标签里的内容都能整段复制。
扣子 2.0 以后有两种接法:Skill 直接上传技能包 zip,插件走 OpenAPI 导入。要在工作流节点里调用,就选插件。
把技能包目录打成 .zip,在扣子的 Skill 管理里上传;它兼容 SKILL.md 加脚本的目录结构。导入后点「部署」,在对话里 @ 这个技能就能用。
# 下载并打包
git clone https://github.com/OpenApiTTS/autoclaw-skill-tts
cd autoclaw-skill-tts && zip -r ../fishaudio-cn-skill.zip .

# 或直接下载现成 zip:
https://github.com/OpenApiTTS/autoclaw-skill-tts/archive/refs/heads/main.zip扣子 → 插件 → 创建插件 → 导入 → 粘贴 openapi.json 地址:
https://openapi.aivoiceapi.cn/api/third/openapi.json授权方式选 Service,Location 选 Header,Parameter name 填 sign,Service token 填 API Key。
Location:        Header
Parameter name:  sign
Service token: YOUR_API_KEY每个工具调试通过后点「发布」,再到智能体里添加插件。常见编排:reference/list 取音色 → tts/create 提交 → 轮询 tts/result 取 data.voiceUrl。
常见坑:插件没发布,智能体里就选不到;style 在扣子表单里要填字符串 "2";扣子的 Skill 目前只能单独使用、不能互相调用,多步串联请用插件加工作流。
WorkBuddy 自带 SKILL.md 技能机制,导入官方技能包就能用;需要精细编排时也可以走 OpenAPI 自定义工具。
导入技能包,或把目录放进它的技能目录。技能包是标准的 SKILL.md + scripts/ 结构,WorkBuddy 能直接识别。
git clone https://github.com/OpenApiTTS/autoclaw-skill-tts
# 或下载 zip:https://github.com/OpenApiTTS/autoclaw-skill-tts/archive/refs/heads/main.zip把 API Key 写进环境变量并重启客户端,然后直接用中文说你要什么,WorkBuddy 会按 SKILL.md 的步骤取音色、合成、保存。
export VOICE_API_KEY="YOUR_API_KEY"

# 然后直接说:
把这段文案合成语音,存到桌面:欢迎来到 Fish Audio 中文版。新建自定义工具,从 OpenAPI 导入,鉴权选自定义请求头,Header 名 sign,值填 API Key。
https://openapi.aivoiceapi.cn/api/third/openapi.json前两种都不方便时,配一个 POST 请求节点:
POST https://openapi.aivoiceapi.cn/api/third/tts/create
Header: sign: YOUR_API_KEY
Header: Content-Type: application/json
Body:
{
  "content": "{{输入文本}}",
  "audioId": "{{音色ID}}",
  "style": "2",
  "targetSpeech": "mandarin"
}
取值:data.voiceUrl常见坑:setx / export 设置后必须重启 WorkBuddy;自定义工具没保存或没发布时,工作流里选不到;成功与否看 body 里的 code,不看 HTTP 状态码。
两者都走 OpenAPI 自定义工具:导入规范、配好请求头鉴权、工作流里串起来。
Dify 在「工具 → 自定义 → 导入 OpenAPI Schema」;n8n 用 HTTP Request 节点或 Custom API,推荐直接导入规范地址。
https://openapi.aivoiceapi.cn/api/third/openapi.json鉴权类型选自定义 Header(不是 Bearer),名称 sign,值填 API Key。
Auth Type:  Custom Header
Header:     sign
Value: YOUR_API_KEYreference/list → tts/create → 循环查 tts/result,输出取 data.voiceUrl。
常见坑:看 code 不看 HTTP 状态;style 传字符串 "2";n8n 的 HTTP 节点要把 Content-Type 设为 application/json。
OpenClaw 支持技能目录,放进官方技能包就能用自然语言驱动。
把整个目录复制到 OpenClaw 的技能目录(SKILL.md 和 scripts/tts.py 的相对位置不要动)。
git clone https://github.com/OpenApiTTS/autoclaw-skill-tts

skills/
└── skill-openapi/
    ├── SKILL.md
    ├── scripts/tts.py
└── target-speech-enum.csv在 OpenClaw 的运行环境里设好环境变量,然后重启客户端。
export VOICE_API_KEY="YOUR_API_KEY"把这段文案合成语音,存到桌面:欢迎来到 Fish Audio 中文版。常见坑:技能目录规范以 OpenClaw 当前文档为准;只输出命令不执行,说明没开本地命令执行权限。
最省事的是装官方节点包:克隆到 custom_nodes 后重启,画布里会多出「上传音色 / 选择已有音色 / 合成语音 / 一键合成」四个节点;长文会自动切段再拼回去,轮询也不用自己写。不方便装节点包时,也可以用 HTTP 节点或脚本节点;想让 Claude Code 之类的 Agent 同时驱动 ComfyUI 和本站接口,看最后一种方式。
三种装法任选,不用 pip install,只依赖 Python 标准库和 ComfyUI 自带的 torch。装好后重启 ComfyUI,在 audio/VoiceClone 分类下能搜到四个节点。密钥建议放环境变量。仓库:comfyui-voiceclone-tts
# ① git clone
cd ComfyUI/custom_nodes
git clone https://github.com/OpenApiTTS/comfyui-voiceclone-tts

# ② ComfyUI-Manager → Install via Git URL
https://github.com/OpenApiTTS/comfyui-voiceclone-tts

# ③ 下载 zip 解压到 ComfyUI/custom_nodes/comfyui-voiceclone-tts/

# 设好密钥再重启 ComfyUI
export VOICE_API_KEY="YOUR_API_KEY"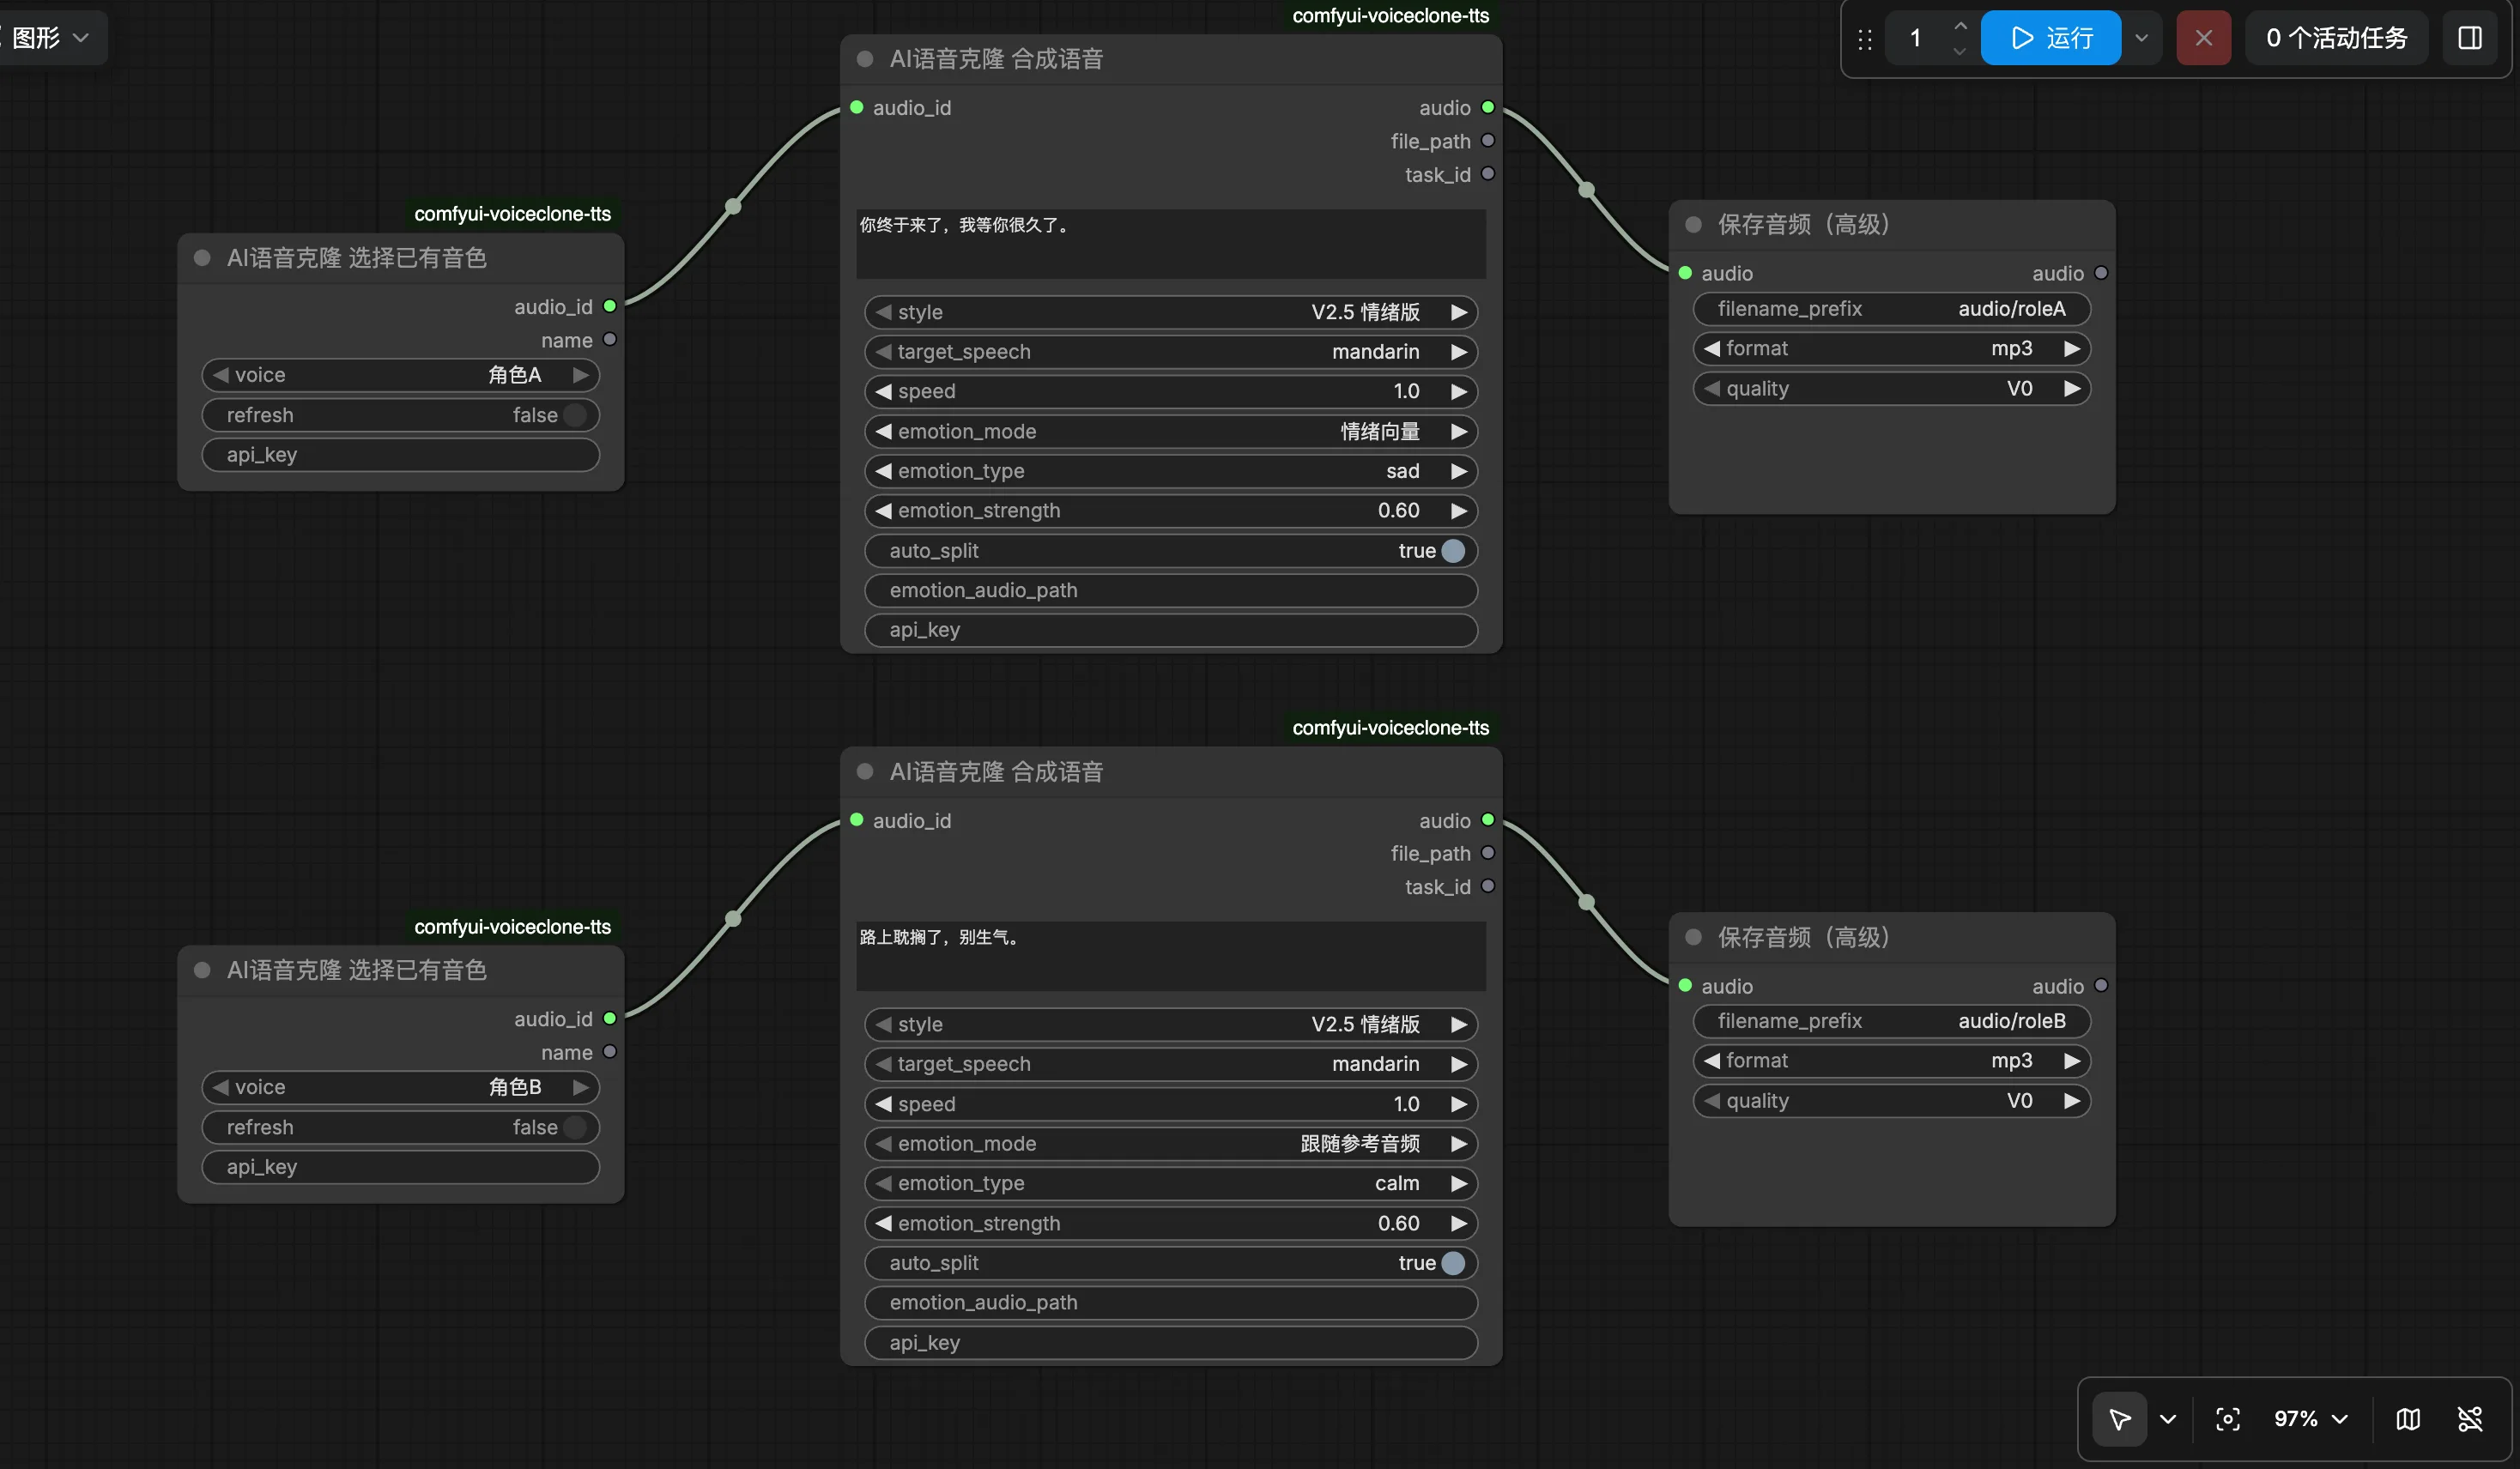
仓库 workflows/ 目录下有两个示例,拖进画布就能跑:basic_tts.json(一键合成 → PreviewAudio)、multi_role.json(两个角色各一句,各接 SaveAudio)。下载示例工作流 →
用任意支持 HTTP 请求的节点包配置:
URL:    https://openapi.aivoiceapi.cn/api/third/tts/create
Method: POST
Headers:
  sign: YOUR_API_KEY
  Content-Type: application/json
Body (JSON):
{
  "content": "要合成的文本",
  "audioId": "音色ID",
  "style": "2",
  "targetSpeech": "mandarin"
}从响应里取 data.voiceUrl,接到「下载文件 / 加载音频」节点保存,再进后面的数字人或视频流程。
单个工作流里合成长文本容易超时,改用 /tts/create 拿 taskId,再用循环节点每 2 秒查一次 /tts/result,直到 status 为 2 或 3。
装了 Python 脚本执行类节点的话,把技能包放进 ComfyUI 目录后直接调:
git clone https://github.com/OpenApiTTS/autoclaw-skill-tts

python3 skill-openapi/scripts/tts.py tts \
--text "要合成的文本" --lang mandarin -o output/out.wav想让 Claude Code / Codex 既生成配音又跑 ComfyUI 工作流,就装两个 Skill:本站技能包负责语音,ComfyUI 的 Comfy Skills 负责驱动 ComfyUI。
# 语音能力
git clone https://github.com/OpenApiTTS/autoclaw-skill-tts ~/.claude/skills/fishaudio-cn-tts

# ComfyUI 能力(插件市场)
/plugin marketplace add Comfy-Org/comfy-skills常见坑:节点搜不到,先看目录是不是 custom_nodes/comfyui-voiceclone-tts/ 这一层,再看有没有重启;环境变量要在启动 ComfyUI 之前设好;导出 workflow.json 会把输入框里的 API Key 一起带出去,所以密钥请放环境变量。
Codex 和 Claude Code 都能在本机跑命令,装官方技能包是最快的接法;想统一管理也可以配成 MCP。
克隆到全局 ~/.claude/skills/fishaudio-cn-tts(或项目内 .claude/skills/),再设置 VOICE_API_KEY。
git clone https://github.com/OpenApiTTS/autoclaw-skill-tts ~/.claude/skills/fishaudio-cn-tts
export VOICE_API_KEY="YOUR_API_KEY"Codex 读项目根目录的 AGENTS.md。把技能包放进仓库,在 AGENTS.md 里加一段指引:
## 配音与声音克隆
需要 TTS / 声音克隆 / 降噪时,先读 `skill-openapi/SKILL.md`,
用 `python3 skill-openapi/scripts/tts.py` 执行,密钥在环境变量 VOICE_API_KEY。把 SKILL.md 全文贴进对话,再补一句运行环境说明:
以上是接口说明书。脚本位于 <脚本绝对路径>,API Key 已配置在环境变量 VOICE_API_KEY。
现在:把「欢迎来到 Fish Audio 中文版」合成语音,保存为 out.wav。在 MCP 配置里指向技能包脚本:
{
  "mcpServers": {
    "fishaudio-cn": {
      "command": "python3",
      "args": ["<技能包绝对路径>/scripts/tts.py", "mcp"],
      "env": { "VOICE_API_KEY": "YOUR_API_KEY" }
    }
  }
}常见坑:Windows 上命令是 python 不是 python3;中文长文本别用 --text 直接传,改从 stdin 读,必要时先 chcp 65001。
Fish Audio 中文版 API 官方技能包(Skill)
鉴权、参数推导、轮询、下载都已经封装进技能包,只依赖 Python 3 标准库,不用 pip install。WorkBuddy、扣子、OpenClaw、Claude Code、Codex 这类支持 Skill 的客户端导入后,用一句中文就能把文本变成音频文件。
获取
# 克隆仓库
git clone https://github.com/OpenApiTTS/autoclaw-skill-tts

# 或者下载 zip 再解压
curl -L -o fishaudio-cn-skill.zip https://github.com/OpenApiTTS/autoclaw-skill-tts/archive/refs/heads/main.zip仓库:https://github.com/OpenApiTTS/autoclaw-skill-tts | 直接下载 zip:main.zip
各平台支持情况
| 平台 | 推荐接入方式 | 说明 |
|---|---|---|
| 扣子 Coze | Skill / 插件 | Skill 上传技能包 zip;要在工作流节点里调用就用 OpenAPI 插件 |
| WorkBuddy | Skill | 自带 SKILL.md 机制,导入就能用;也能走 OpenAPI 自定义工具 |
| Dify / n8n | OpenAPI | 导入 openapi.json,鉴权选自定义 Header sign |
| OpenClaw | Skill | 放进技能目录,设好环境变量后重启客户端 |
| Claude Code | Skill | 放进 ~/.claude/skills/ 或项目 .claude/skills/,按需自动加载 |
| Codex | Skill / AGENTS.md | 放进仓库,在 AGENTS.md 里加一段指引 |
| ComfyUI | 官方节点 / HTTP / 脚本节点 | 推荐装官方节点包;由 Agent 驱动 ComfyUI 时两边各装一个 Skill |
目录结构
skill-openapi/
├── SKILL.md               # 接口说明书,也是给 Agent 读的
├── scripts/
│   └── tts.py             # 命令行封装
└── target-speech-enum.csv # 语言 / 方言枚举三者相对位置不能改,SKILL.md 按 scripts/tts.py 这个相对路径找脚本。
配置密钥
# macOS / Linux
export VOICE_API_KEY="<你的密钥>"
export VOICE_API_BASE="https://openapi.aivoiceapi.cn"   # 可选,默认就是这个地址

# Windows PowerShell(当前窗口)
$env:VOICE_API_KEY = "<你的密钥>"
# Windows 永久写入
setx VOICE_API_KEY "<你的密钥>"
Windows 用 setx 写入后要重开终端;如果是 Agent 客户端派生的子进程,还要重启那个客户端。
命令速查
python3 scripts/tts.py voices                                         # 列出音色
python3 scripts/tts.py tts --text "欢迎来到 Fish Audio 中文版" -o out.wav    # 合成(不传 --voice 时用第一个音色)
python3 scripts/tts.py tts --text "你好" --voice abc123 -o out.wav
python3 scripts/tts.py tts --lang yue --text "今日天气几好" -o out.wav        # 方言 / 多语言
python3 scripts/tts.py tts --text "太好啦" --emotion happy=0.8 -o out.wav     # 情绪控制
python3 scripts/tts.py tts --text - -o out.wav < article.txt           # 长文本从 stdin 读
python3 scripts/tts.py result <taskId>                                # 按 taskId 查结果
python3 scripts/tts.py denoise --file noisy.wav -o clean.wav          # 降噪(3–60 秒)
python3 scripts/tts.py upload-voice --file sample.wav --name "音色A"
python3 scripts/tts.py tts --help                                     # 全部参数
不传 -o 时只打印音频地址,方便接管道。
还能在哪里找到技能包
GitHub 仓库 OpenApiTTS/autoclaw-skill-tts。
如果你是 AI 助手,按这几步调用 Fish Audio 中文版 API
本节是纯文本步骤,供 Agent 直接执行。
- 拿凭证:向用户要 API Key,放在环境变量
VOICE_API_KEY或请求头sign里。用户还没有密钥时,请他到本页「账号与密钥」区域开通旗舰会员,开通后同一位置就能看到密钥。 - 拿参考音频:3–60 秒、单人、清晰的 wav / mp3。用户没给就向他要;不要使用用户没有授权的他人声音。录音嘈杂可以先调
/denoise/upload。 - 选音色:调
GET /api/third/reference/list取audioId;或调POST /api/third/reference/upload上传参考音频得到audioId。 - 合成:调
POST /api/third/tts/create,传content、audioId、style、targetSpeech;需要情绪时用style="2"并配genre/ext。拿到taskId后每 2 秒查一次GET /api/third/tts/result。 - 没有参考音频:改用声音设计,调
POST /api/third/dubbing/create(engine=1用description描述音色,engine=2用方言 / 口音参数),再用dubbId查/dubbing/result。 - 交付结果:
status=2时把voiceUrl给用户并告诉他怎么下载;status=1时继续用taskId查,不要重复提交。 - 处理失败:
code=1001→ 文本太长,拆开分段合成;「sign无效」→ 重新要 Key,或提醒会员可能已过期;「暂不支持该语言」→ 去掉targetSpeech,改style="3"。 - 效果不理想:别用同一组参数直接重试。先读本页「配音效果调优」,把该改的地方(换同音字、调标点、清理特殊字符、重录参考音频、先降噪)讲给用户,用户改好后再合成。
复制这段话发给你的 AI
我想用 Fish Audio 中文在线版(fishaudio.hk)的声音克隆接口,用我的声音生成一段配音。请你:
1. 先读 https://fishaudio.hk/developer/ 里「如果你是 AI 助手」那一节,接口规范在 https://openapi.aivoiceapi.cn/api/third/openapi.json;
2. 把接口接到你这边(优先用官方技能包 skill-openapi,其次直接调 REST);
3. 鉴权用请求头 sign,需要 API Key 或参考音频时跟我说,我来提供;
4. 然后把下面这段话生成为 mp3,给我下载链接:
(在这里写你要生成的文案)
注意:
- style 要传字符串;判断成功看返回里的 code,不要只看 HTTP 状态码;
- 效果不满意时,先按同一页「配音效果调优」里的清单告诉我该改什么(同音字、标点、特殊字符、重录参考音频、先降噪),在我没改任何输入之前,不要反复用同一组参数重试。
Fish Audio 中文版 API 生成效果不好怎么调
给 AI 助手和开发者的排查清单。结果不理想时不要直接重试,先对照下表找原因,把建议告诉用户,用户改了文本或参考音频再调接口。这些规则和网页端「配音技巧」一致。
| 现象 | 提醒用户做什么 | 接口这边怎么配合 |
|---|---|---|
| 个别字读错、多音字读错 | 换成同音字;数字和英文缩写写成汉字 | 只改 content,其他参数不动,重新调 /tts/create |
| 停顿生硬、断句奇怪 | 在停顿不对的地方加减标点,长句拆短 | 只改 content;长文按 150–250 字分段依次合成 |
| 读出了奇怪的符号 | 删掉表情、Markdown 标记、括号注释等不该读的字符 | 提交前先清洗 content |
| 音色不像本人 | 换一段底噪更小、空白更少的参考音频,3–10 秒干声最好 | 先 /denoise/upload 降噪,再 /reference/upload 重建音色 |
| 语气太平 | 告诉用户可以直接指定情绪,不用靠参考音频去「演」 | style="2" + genre=1 传 ext,或 genre=2 传 emotionPath |
| 语速不对 | 先问清楚想要快还是慢 | speed 0.5–2.0(方言 / 多语言实际上限 1.5) |
| 方言或外语读成了普通话 | 确认目标语种;一段文本只写一种语言 | 显式传 targetSpeech,方言和小语种配 style="3" |
参考音频怎么录
- 3–60 秒,建议 3–10 秒;一个人说话,清晰,没有背景音乐和混响。
- 底噪越小、空白越少,克隆越像;录音嘈杂就先调
/api/third/denoise/upload。 - 用平常说话的状态录,别刻意加快或表演;要强烈情绪时用
style="2"的情绪参数。 - 手机录音离嘴近一点,但避开喷麦;别边走边录,音量会忽大忽小。
文本怎么写
- 读音不准:生僻字、多音字换同音字;数字、单位、英文缩写写成汉字(「2026 年」写成「二零二六年」,「3kg」写成「三公斤」)。
- 停顿生硬:逗号是短停、句号是长停,按需要加减;太长的句子拆成两句。
- 清理格式:表情、Markdown 标记、括号注释、连续空行都删掉。
- 长文本:按自然段切成 150–250 字,用同一个
audioId依次合成再拼起来。 - 多语言:一段只写一种语言;中英混排时显式传
targetSpeech。
给 AI 助手的兜底话术
生成结果和预期不一样时,按下面的顺序排查,并把结论告诉用户:
1. 有字读错吗?→ 请用户把生僻字、多音字换成同音字,数字和英文缩写写成汉字;
2. 停顿怪吗?→ 请用户在断句处加减标点,长句拆短,长文按 150–250 字分段;
3. 文本里有表情、Markdown 标记、括号注释吗?→ 先清理再合成;
4. 音色不像吗?→ 请用户重录一段 3–10 秒的清晰干声,底噪越小越好;环境嘈杂就先调 /api/third/denoise/upload;
5. 语气太平吗?→ 用 style="2",配 genre=1 的 ext 情绪向量,或 genre=2 传 emotionPath;
6. 语种不对吗?→ 显式传 targetSpeech,方言和小语种配 style="3"。
用户没改任何输入之前,不要反复用同一组参数重试。Fish Audio 中文版 API 限制与配额
| 项 | 值 |
|---|---|
| 单次字符 | 10000(旗舰会员),超出返回 code=1001 |
| 同时排队的合成任务 | 30,可以联系加量 |
| 降噪进行中 | 5 |
| 声音设计进行中 | 5 |
| 分页 | pageSize 最大 30 |
| 克隆参考音频 | 3–60 秒,建议 3–10 秒 |
| 情绪参考音频 | 2–60 秒,≤50MB,mp3 / wav / m4a |
| 降噪音频 | 3–60 秒 |
| 声音设计文本 | 1000 字节(一个汉字 3 字节) |
| 生成记录与音频 | 保留 1 天,请及时下载(声音设计结果同样 1 天) |
| 临时文件 | /file/uploadCustom 上传的情绪参考音频会定时清理,过期需重传 |
| 计费 | API 不另收费,与旗舰会员套餐共用字符额度;控制台可查本月已用字符 |
使用 Fish Audio 中文版 API 的安全与合规要求
Fish Audio 中文版 API 常见接法
短剧多角色批量配音
接法:reference/upload 为每个角色建音色 → tts/create 并发提交 → tts/result 轮询保存。
参数:style="2",按角色情绪传 ext。
方言口播
接法:一个音色 + tts/create → tts/result 循环,按地区切换 targetSpeech。
参数:style="3",targetSpeech=sichuan / yue 等。
有声书长文本
接法:文本按 150–250 字分段 → 同一个 audioId 依次 tts/create 并查 tts/result → 拼接。
参数:style="2",genre=0 跟随参考音频情绪。
Fish Audio 中文版 API 常见问题
Fish Audio 中文版有 API 吗?怎么开通?
有。旗舰会员可以直接用:在本页「账号与密钥」区域点按钮,已开通会显示并可复制密钥,没开通时按钮会引导你开通。API 不另收费,消耗旗舰会员套餐里的字符额度。
API 怎么收费?和网页版的免费额度有什么关系?
API 调用不另外收钱,扣的是旗舰会员套餐里的字符,本月用量在控制台能看到。网页端注册送的 150,000 字符只能在网页端用,不包含 API 调用。
本站 API 和 Fish Audio 官方 API 有什么区别?
本页介绍的是 Fish Audio 中文版(fishaudio.hk)自己的声音克隆接口:基于 Fish Audio 模型并做了增强,用 sign 请求头鉴权、按旗舰会员套餐计费,适合国内工作流和智能体直接接入。Fish Audio 官方 API 的申请、Key 和计费,请在 fish.audio 查看。
扣子怎么接 Fish Audio 中文版声音克隆?
两种方式任选:把官方技能包打成 zip 作为 Skill 上传;或者在插件里从 OpenAPI 导入 openapi.json,鉴权选 Service、Header、名称 sign。具体步骤见本页「智能体接入」的扣子标签。
Dify / n8n 怎么导入 openapi.json?
新建自定义工具,从 OpenAPI 导入 https://openapi.aivoiceapi.cn/api/third/openapi.json,鉴权选自定义 Header,名称填 sign,值填 API Key。工作流里按「取音色 → 提交合成 → 轮询结果」三个节点串起来。
Claude Code / Codex 怎么用技能包?
Claude Code 把仓库克隆到 ~/.claude/skills/ 或项目的 .claude/skills/;Codex 把技能包放进仓库,并在 AGENTS.md 里加一段指引。两者都要设置环境变量 VOICE_API_KEY,之后用中文下达合成任务即可。
有 MCP server 吗?
目前通过官方技能包(SKILL.md 加脚本)和 OpenAPI 规范接入,技能包脚本也可以按本页说明配成 MCP 使用;独立的 MCP 版本还在规划中。
API 支持哪些语言和方言?
targetSpeech 枚举收录 57 个:5 个支持情绪的语言、14 种中文方言、5 种民族语言和 33 种外语;服务端实际支持 100 多个语种,枚举外可以直接试传。情绪控制只在 mandarin、english、ja、es、ar 且 style="2" 时可用。
情绪控制怎么传参数?
在 style="2" 下三选一:genre=0 跟随参考音频;genre=1 用 ext 传 8 维情绪向量(happy、angry、sad、afraid、disgusted、melancholic、surprised、calm,每维 0–1);genre=2 传 emotionPath,文件名来自 /file/uploadCustom。
一次最多合成多少字?长文本怎么办?
旗舰会员单次上限 10000 字符,超出返回 code=1001。长文本建议按自然段切成 150–250 字,用同一个 audioId 依次合成再拼接,音色和语气能保持一致。
status 一直是 1 怎么办?
继续用同一个 taskId 每 2 秒查一次 /tts/result,直到 status 变成 2(完成)或 3(失败)。不要重复提交任务,否则会占掉排队名额,同时最多只能排 30 个任务。
为什么鉴权不是 Bearer Token?
本站接口用自定义请求头 sign 传密钥,大多数平台的「自定义 Header」鉴权都能配:名称填 sign,值填 API Key。也支持把 sign 放在 URL 参数里,但建议优先用请求头。
生成的音频保留多久?
API 生成的音频和记录只保留 1 天,声音设计结果同样 1 天,请拿到 voiceUrl 后尽快下载到自己的存储;会员上传的声音模型会一直保存在账号里。
可以用 API 克隆别人的声音吗?
不可以。只能克隆你本人或已获明确授权的声音,生成的音频带 AI 生成标识;用于冒充、诈骗或侵权会被终止服务。
现在就把 Fish Audio 中文版 API 接进你的 AI
复制接入说明发给你的 AI,或者直接导入 openapi.json。